
翻訳品質
AI翻訳の品質を、感覚ではなく採点基準と数値で示します
社内の翻訳品質評価チーム(翻訳ラボ)が、主要なAIモデルの翻訳結果を毎日同じ条件で比較しています。評価基準や採点方法、データ保護方針を公開し、社内での導入検討に役立てていただけます。
実際の翻訳品質を導入前に確認できます
毎日同じ条件で比較
主要なAIモデルを複数の言語と文章で毎日比較し、感覚ではなく継続的な結果に基づいて判断します。
6つの観点で100点満点評価
訳文の正確さに加え、流暢さや一貫性、文化的妥当性まで含めて点数化します。
翻訳データの学習利用なし
翻訳に使われるテキストは、AIモデルの学習データとして一切利用されません。
品質評価の仕組み
一時的な印象で判断せず、毎日同じ原文と条件でAIモデルを比較し続ける体制を整えています。
毎日同じ条件で品質のばらつきを追跡
プレスリリース、ブログ記事、IRメッセージ、文芸作品などの原文を使い、毎日同じ条件で品質のばらつきを追跡しています。
主要なAIモデルを横並びで比較
OpenAI、Anthropic、Geminiに加え、主要なオープンモデルを同じ原文で比較評価しています。
判断基準と品質の目安を公開
訳文をどの基準で評価し、どの水準を満たせば実用に適するかを公開しています。
翻訳データの学習利用を防止
翻訳に使われるテキストは、AIモデルの学習データとして一切利用されません。
日次の評価フロー
同じ条件で各モデルを実行
比較対象のAIモデルに同じ原文を渡し、条件をそろえて翻訳を実行します。
言語ごとに結果を横並びで確認
英語・中国語・韓国語などを並べ、モデルごとの特徴や言語による違いを確認します。
6つの評価軸で採点
正確さだけでなく、流暢さや文化的妥当性を含めた6つの軸で点数化します。
モデル選定と確認ルールに反映
毎日の評価で把握した傾向をもとに、当社でのモデル選定や公開前の確認ルールに反映します。
評価基準と採点
1文単位の訳が正しくても、前後の文との整合性や言い回しの統一がなければ業務では使えません。
そのため、AIシュリーマンでは6つの観点から総合的に評価し、100点満点で採点しています。
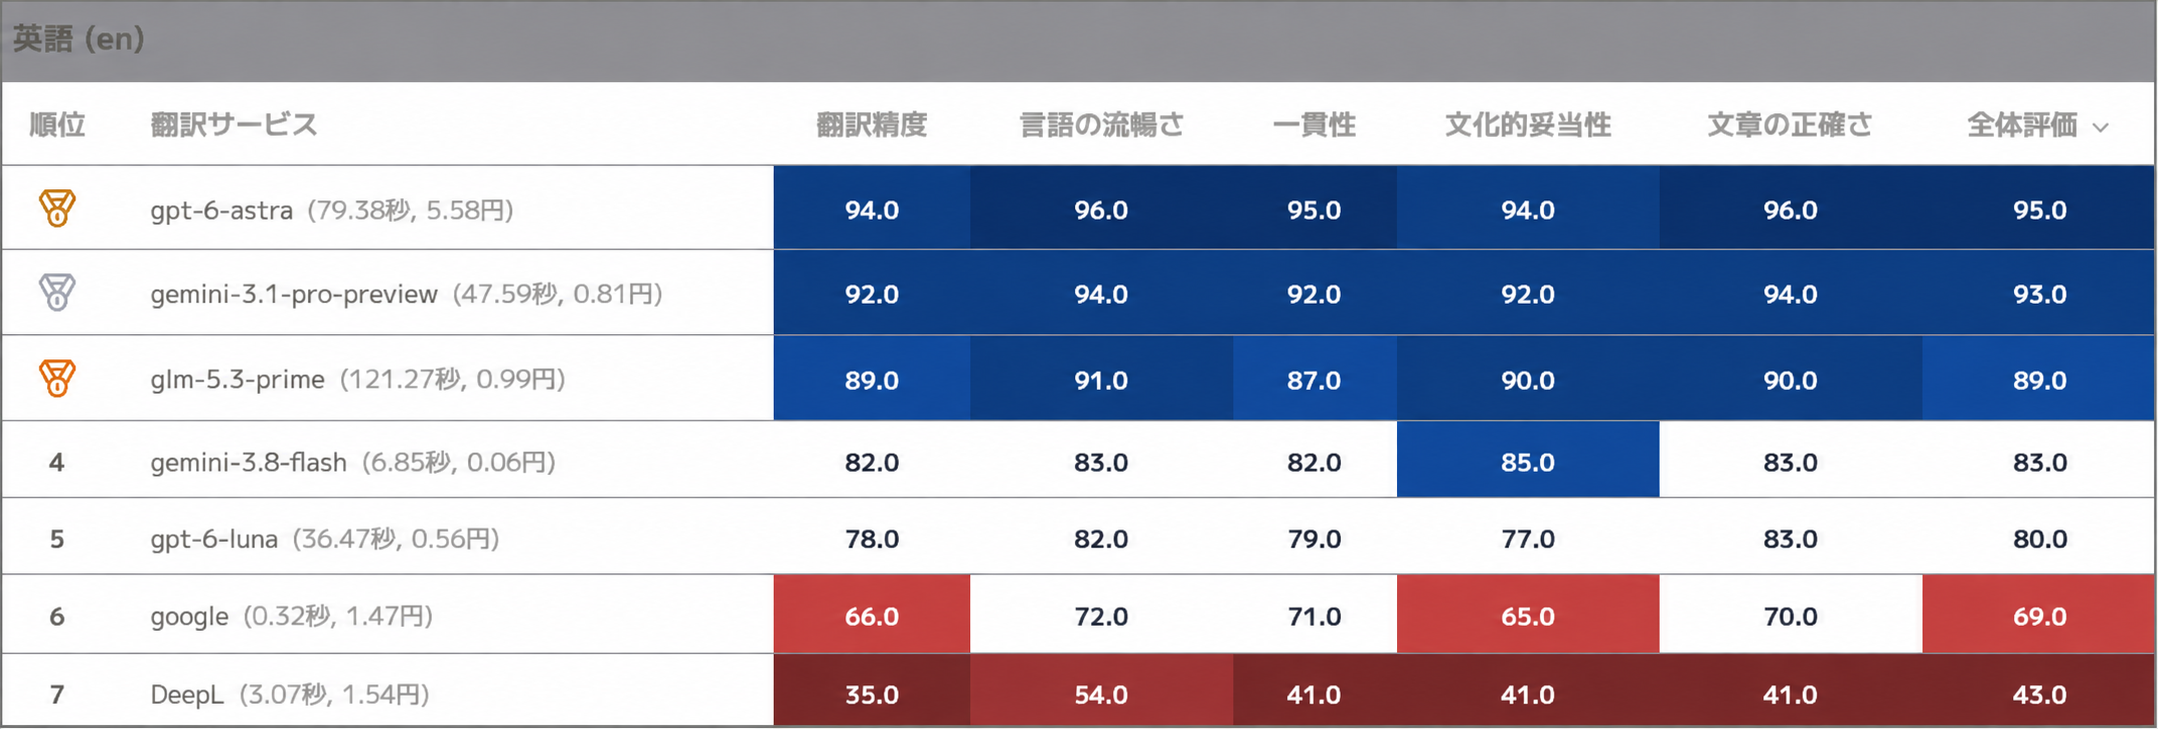
6つの評価軸
翻訳精度
原文の意図や情報、ニュアンスが正確に伝わっているか。
言語の流暢さ
翻訳先の言語として自然で読みやすい文章になっているか。
一貫性
翻訳文の中で文体や用語、トーンが統一されているか。
文化的妥当性
翻訳先の文化において不自然さがなく、誤解を招かない表現か。
文章の正確さ
固有名詞や日付、数値、引用が原文通り正確に訳されているか。
全体評価
各観点を総合し、Webサイトに公開できる品質を満たしているか。
100点満点の採点基準
翻訳者を上回るレベル
平均的なプロの翻訳者を上回る水準
プロの翻訳者レベル
公開前の大きな修正をほとんど必要としない水準
ネイティブに近いレベル
軽微な調整で商用利用に十分使える水準
ほぼ違和感がないレベル
多くの場面でそのまま読める実用水準
改善の余地があるレベル
意味は伝わるが、人の確認を推奨する水準
見直しが必要なレベル
手直しなしでは使えない水準
※高スコアの文章でも、法務やIR、価格表記などの重要な文面は人の確認を推奨しています。